MIT6.5840 Lab 1:MapReduce
相关:
实验目标:实现一个 MapReduce 框架。
实验中以 “coordinator” 来替代 paper 中的 “master”
顺序版 MapReduce
试执行
src/main/mrsequential.go是一个简单的、已完成的顺序版 MapReduce 实现。它在单个进程中,一个接一个依次执行 Map、Reduce 操作。- 输入文件为
pg-xxx.txt - 输出文件为
mr-out-0
- 输入文件为
- 实验提供了几个 MapReduce 应用示例:
mrapps/wc.go:词频统计mrapps/indexer.go:文本索引器
可以按照以下步骤来运行词频统计程序
$ cd ~/6.5840
$ cd src/main
$ go build -buildmode=plugin ../mrapps/wc.go  #编译到当前目录下,生成wc.so
$ rm mr-out*    #清理旧输出
$ go run mrsequential.go wc.so pg*.txt #编译并运行单机顺序版的MR框架主程序,传入刚刚编译好的词频统计插件,并传入待处理的输入文本文件。
$ sort mr-out-0
| 特性 | go run |
go build |
|---|---|---|
| 主要用途 | 开发调试、快速验证代码 | 项目构建、部署、正式运行 |
| 产物文件 | 不会在当前目录留下任何可执行文件 | 在当前目录(或指定目录)生成可执行二进制文件 |
| 编译机制 | 在临时目录编译 → 立即执行 → 自动清理临时二进制文件 | 编译并输出结果文件到磁盘 |
| 二次运行速度 | 每次都需要重新走一遍编译 + 运行过程 | 直接运行生成的二进制文件(极快) |
| 依赖环境 | 目标机器必须安装 Go 环境 | 运行机器不需要安装 Go 环境 |
wc.go不是一个独立运行的程序,它里面没有main()函数。因此这里的目标是把它编译成一个.so格式的动态链接库(插件)。go run的本质是“编译并立即执行main函数”。既然wc.go没有main函数,直接go run会直接报错。必须用go build并加上指定参数-buildmode=plugin才能把它打包成插件文件wc.so。mrsequential.go是包含main()函数的主函数。用go run可以一步编译 + 执行 + 清理。当然也可以全部用go build,步骤如下:
# 1. 编译 MapReduce 应用插件
go build -buildmode=plugin ../mrapps/wc.go

# 2. 编译主程序引擎,生成可执行文件 mrsequential
go build mrsequential.go

# 3. 清理旧输出
rm mr-out*

# 4. 直接运行编译好的二进制文件
./mrsequential wc.so pg*.txt

# 5. 排序查看结果
sort mr-out-0
- 动态链接库是一组编译好的可执行代码和数据的文件。Linus 上以
.so结尾,在 Windows 上以.dll结尾- 不独立运行:没有
main函数,不能像软件一样双击直接启动 - 共享与解耦:主程序可以在启动/运行时去加载它,直接调用里面的函数
- 减少体积:不同软件可以共享同一个
.so文件,无需每个软件都拷贝一份代码。
- 不独立运行:没有
- 插件:是一种软件设计模式,动态链接库是实现插件的一种底层技术载体。
- 插件机制允许软件在不重新编译主程序的情况下,动态地扩展、替换功能。
- mrapps 下的文件会报错:
xx redeclared in this block,因为 src/mrapps/ 目录下的多个 Go 文件都声明了各自的 Map 和 Reduce 函数,而你可能尝试一次性编译整个目录,因此报错。 - 这些 Go 文件分别表示一个独立的 MapReduce 应用插件,每次只能编译一个文件。一次性编译整个目录会导致重复声明错误
mrsequential.go 中的代码
实验采用的排序方法是
sort.Sort:定义一个自定义类型ByKey,并实现sort.Interface接口,从而实现ByKey类型变量的排序。这是 Go 最原始的排序方式,目前在新版本中已被 slices 包取代。:具体见Go语言:从排序功能看接口、反射、闭包、泛型实验代码中采用
os.Open+ioutil.ReadAll+file.Close进行“打开文件、读取全部内容、自动关闭文件”,这个过程已经被os.ReadFile(filename)替代:Go语言中的标准库-基础输入输出
它的核心作用是:在单个进程中,按顺序模拟运行标准 MapReduce 的完整生命周期(动态加载插件
main 函数逻辑如下:
- 初始化与插件加载:
- 命令行参数校验。
- 用
loadPlugin动态提取用户自定义的 Map 函数和 Reduce 函数。
- Map 阶段:
- 依次遍历命令行参数中给出的文件,读取文件内容。对于每个文件:
- 将内容和文件名传入
mapf函数,获得一批中间键值对 - 将键值对合并到内存切片
intermediate[]
- 将内容和文件名传入
- 依次遍历命令行参数中给出的文件,读取文件内容。对于每个文件:
- Shuffle 阶段(分组与排序):
- 对内存中收集到的所有中间键值对按照 Key 排序。
通过排序,保证所有相同 Key 的数据在内存数组中处于连续紧邻的位置,为接下来的合并分组做准备。
真正的分布式 MapReduce 会将中间数据按 Hash 分发到
个 Bucket 中;而这里的串行版本直接将所有数据存在单一内存空间里统一排序。
- Reduce 阶段
- 每次循环处理一个 key(分组)
- 将所有 key 相同的键值对提取到
values[]中 - 将 Key 和
values[]传入reducef函数,进行化简。 - 将这个 key 的最终化简结果打印到指定文件中。进行下一个循环
- 将所有 key 相同的键值对提取到
- 每次循环处理一个 key(分组)
import 来导入 map 和 reduce 函数?
src/mrapps下有许多 MapReduce 应用,每个应用的 Map 和 Reduce 函数都不一样(由用户自定义)。如果使用import来导入,例如import "6.5840/mrapps/wc",硬编码导入 wc 包,框架只能使用 wc 这个应用。如果要修改应用,必须修改框架源代码 + 重新编译。- 由于所有函数都被命名为
Map和Reduce,因此也无法在一个文件里通过import把它们同时导进来。Go 不支持同一个包里出现同名符号 - 用
loadPlugin方式,框架代码只需编译一次,生成一个可执行文件。不同的业务逻辑独立编译成不同的插件,运行时只需通过命令行更换参数即可。
loadPlugin 函数(命令行参数为 wc.so,并以map 的加载为例)
plugin.Open(): 将wc.so载入当前进程的内存地址空间p.Lookup("Map"):在符号表中查找 "Map" 内存地址,返回一个空接口类型plugin.Symbol,表示一个通用的内存地址指针,Go 还不知道这个符号具体是什么类型的函数或变量。- 类型断言:将
xmapf强转为特定的函数类型(与Map的函数签名保持一致),返回函数指针,赋值给mapf。
mapf := xmapf.(func(string, string) []mr.KeyValue)
- 提取出的
mapf作为普通的 Go 函数变量返回。
- Map:是一个函数类型。可以用它来声明一个函数变量(就如可以用 int 类型来声明一个 num 变量一样)
- xmapf:第二步中,返回的是一个空接口类型的变量,Go 不确定当前变量的具体类型。
x是一个常见的命名惯例,用来表示“未经类型转换前的原始变量/未知变量” - mapf:它是通过类型断言强转后得到的函数变量,是一个具有特定签名的标准 Go 函数。另外,
map是 Go 语言的关键字,不能作为变量名;用mapf表示Map Function,即可以明确变量是一个函数类型,也可以区分阶段和方法(Map 可以指代“Map 阶段/Map 任务”,而mapf则特指“用户写的那个负责具体映射计算的函数”。)- 也可以用
mapFunc来命名。
- 也可以用
Map?
类型断言的语法为 接口变量.(目标类型),括号内必须是一个类型,而不能是一个具体的函数名。
以 Map 函数为例,其签名为:
func Map(filename string, contents string) []mr.KeyValue
- 类型:
func(string, string) []mr.KeyValue是一个函数签名类型,描述了一类函数的输入输出约定,是编译时的元数据。 - 函数:
Map是该类型的一个具体实例,是一个标识符,指向代码段中某段机器指令的起始地址。同一类型下可以有多个不同的函数实例。 - 函数变量:
loadPlugin中的mapf是一个函数变量,本质上是一个指向具体函数的指针,存储在栈或堆上。
因此,类型断言必须使用类型(func(string, string) []mr.KeyValue),而不能使用具体的函数名(Map)。
实验任务概览
实验内容
写两个程序:coordinator.go 和 worker.go
- 并行执行一个 coordinator 进程和一个或多个 worker 进程
- worker 进程通过 RPC 和 coordinator 通信
官方给出了两个初始代码,帮忙起步:coordinator(main/mrcoordinator.go)和 worker(main/mrworker.go)。这两个文件不能修改
我们需要把实现写在 mr/coordinator.go、mr/worker.go、mr/rpc.go
- 前者是进程入口。包括:解析命令行、启动 Coordinator、轮询是否已完成。相当于 Java 中的 Controller 层
- 后者是业务逻辑库。相当于 Java 中的 Service 层
实际上,如果把 Coordinator 的相关代码全写在 mrcoordinator.go 中,也能跑通。但要将它们解耦为两个文件,因为:
- 自动化测试。课程的评测脚本
mr/mr_test.go需要能自动启动 Coordinator、创建 Worker、模拟节点崩溃等。 - 职责分离
运行示例
以word-count 应用为例。
- 编译 word-count 插件
cd MIT6.5840/6.5840/src/main
go build -buildmode=plugin ../mrapps/wc.go
- 在其中一个命令行窗口,运行 coordinator
sock123参数指定了一个套接字(socket),协调器(coordinator)通过它来接收来自 Worker 节点的 RPC 请求。pg-*.txt参数则是输入文件;每个文件代表一个“数据分片”(split),并且会作为单个 Map 任务的输入。
cd MIT6.5840/6.5840/src/main
rm mr-out*
go run mrcoordinator.go sock123 pg-*.txt
- 在另一个命令行窗口,运行一些 worker
cd MIT6.5840/6.5840/src/main
go run mrworker.go wc.so sock123
- workers 和 coordinator 完成后,输出结果在
mr-out-*。输出结果应该和src/main/mrsequential.go的实现结果是一致的。
测试
官方提供了测试代码(位于 mr/mr_test.go),可以在src 目录下运行测试:
- 正确性:它会检查
wc和indexer两个 MapReduce 应用是否能产生正确输出 - 并发:Map 和 Reduce 任务是否是并行运行
- 容错:Worker 节点发生崩溃时,系统能否成功进行故障恢复。
cd src
make mr
预期输出如下:
=== RUN   TestWc
--- PASS: TestWc (8.64s)
=== RUN   TestIndexer
--- PASS: TestIndexer (5.90s)
=== RUN   TestMapParallel         # 测试 Map 是否并行
--- PASS: TestMapParallel (7.05s)
=== RUN   TestReduceParallel      # 测试 Reduce 是否并行
--- PASS: TestReduceParallel (8.05s)
=== RUN   TestJobCount            # 测试 Job 计数
--- PASS: TestJobCount (10.04s)
=== RUN   TestEarlyExit
--- PASS: TestEarlyExit (6.05s)
=== RUN   TestCrashWorker         # 测试 Worker 崩溃容错
2026/01/22 14:58:14 *re*-starting map ... # 看到重新启动任务的日志
--- PASS: TestCrashWorker (40.18s)
PASS
ok      6.5840/mr       86.932s   # 总用时 1 分多钟
如果出现 2026/02/11 16:21:32 dialing:dial unix /var/tmp/5840-mr-501: connect: connection refused 这种报错日志,是正常的。当所有任务做完后,Coordinator 进程会先退出并关闭 RPC 服务。此时可能还有一些“不知情”的 Worker 还在尝试通过 RPC 连 Coordinator,就会报“连接被拒绝”。
规则
- Map 阶段需要将 intermediate key 拆分成
nReduce个桶。每个 Mapper 都需要创建nReduce个 intermediate 文件供 reduce tasks 使用。 - 应该把 Map 阶段的输出放在当前目录下,方便 Reduce 任务进行读取。
- 第 X 个 Reduce 任务的输出必须写到名为
mr-out-X的文件中(如mr-out-3) mr-out-X文件中,每一行分别表示一个 Reduce 函数的输出。输出格式为"%v %v",分别表示 key 和 value。(可以参考main/mrsequential.go)- 可以修改
mr/coordinator.go、mr/worker.go、mr/rpc.go。也可以临时修改main/目录下的文件来做本地 Debug,但是官方评测时会重置并使用原始版本的main/文件。 mr/coordinator需要实现Done()。mrcoordinator.go会不断调用coordinator.Done()。只有当 Map 和 Reduce 所有任务都彻底完成时,Done()返回true,mrcoordinator进程才会安全退出。- Job 结束后,Coordinator 会退出。Worker 需要感知到这一点并且终止进程。
建议:
- 把 Map 阶段输出的中间文件命名为
mr-X-Y- X 表示 Map Task 编号(第几个 Map 任务)
- Y 表示 Reduce Task 编号(分区 ID)
- 设置 Worker 超时时间为 10s
我的实现流程
我的实现是基于 MapReduce 设计流程的。根据设计,来思考实现方式。
注意:
- 本节中的行文思路并非是结论式的,而是过程式的,它记录的是我在实现过程中如何推进、如何决策,而不是纯粹的结论。
- 最好先看 MapReduce 设计流程 ,再看本文。两篇文章有一定的冗余阐述,但这是为了加深理解,本文的实现不能代替前者的设计思路。
- 折叠的引用块代表扩展的内容,并非实验的重点。但如果你感兴趣,也值得一看。
首先要考虑从哪入手。我考虑过两个方向:
- 从顶向下:先查看课程给出的所有函数,分析它们的调用关系与参数,再依次填充每个函数的内部逻辑。这样做的问题是,实现会退化成纯粹的工程问题——各个函数之间的调用关系是交叉的,孤立地逐个填充函数,很容易让思路陷入混乱。
- 按流程推进。根据 MapReduce 设计流程,按顺序推进函数逻辑。简单的说,我遇到什么新问题,我就写什么代码。
- 这一部分的内容是实验中直接给出的,我们无需修改。但我们仍然需要知道实验给出的前提条件是什么,才能基于这些推进流程。
初始数据:src/main/pg-*.txt
设置参数(这些参数都是已经设定的、无需修改的):
- M:即传给 Coordinator 的输入文件的数量。
- R:即
src/mrcoordinator.go中,调用mr.MakeCoordinator时传入的参数nReduce: 10 - 哈希分区函数:(由于是在 Map 阶段进行分区的,所以应该在
worker.go中寻找)ihash(用的是 FNV-1a 算法)
选择哈希算法,首先要在加密哈希算法和非加密哈希算法之间选择:
- 加密哈希算法(MD5、SHA-1、SHA-256):重点在于安全性与防篡改,计算极其复杂,大量消耗 CPU 资源。
- 非加密哈希算法(FNV、MurmurHash、xxHash):重点在于计算速度和离散度。
MapReduce 中,我们需要将海量的 Key 快速打散并分发,因此非加密哈希算法是最优解。接着,我们要在非加密哈希算法之间选择一个合适的算法:
实验中选择 FNV-1a,实际上是出于教学目的。它简洁、易于实现。
阶段一:输入分片与任务分配
注意:实验中 Coordinator 等价于论文中的 Master
这个阶段中,我们需要做什么?
首先要看我们有什么。实验通过通过命令 go run mrcoordinator.go sock123 pg-*.txt 创建一个 Coordinator 进程。因此,Coordinator 所拥有的数据是:
- sockname(相当于 IP:Port,用来标识 Coordinator 进程的位置)
- 一系列输入文件
在操作系统的视角里,mrcoordinator.go 和 coordinator.go 在编译后,被打包进了同一个二进制可执行文件中。进程中始终只有一个 Coordinator 进程。而mr.MakeCoordinator 只是创建了一个 Coordinator 对象(结构体对象)
我们想要完成的是输入分片与任务分配。对于输入分片:
根据 MapReduce 设计流程,我们需要完成物理存储分块和逻辑分配映射两个任务。
- 物理存储分块是由 Google 的 GFS 实现的,将大文件按大小物理切分为多个数据块(Block),分散存储在不同节点的本地磁盘。而我们的实验环境压根就没有分布式文件系统,因此我们只能略过这一步。
- 逻辑分片映射是 MR 框架实现的,Coordinator 需要向文件系统查询,将 Block 映射成逻辑上的 Input Splits(即 Map Tasks)。我们假设:
- 每个
pg-*.txt文本文件恰好是一个数据块(Block) - Coordinator 将这些 Block 映射为 Input Split,分片元数据用文件名表示。
- 不考虑数据本地化调度。
- 每个
在工业级 MapReduce 中,并不是靠文件名来区分 map task,因为一个大文件会被切成很多个 task,MapReduce 传输的是某个字节区间的元数据。但在该实验中采用文件名传输,这是为了降低实验过程难度而做的简化。
因此,输入分片任务无需我们完成,实验已经提供了假设和前提(既是简化,也是约束)。我们只需考虑任务分配。
从直觉上看,任务分配有两种方向:
- 推送(Push):由 coordinator 主动把任务分配给 worker。
- coordinator 必须实时掌握每一个 worker 的状态,对于分布式系统来说,状态同步、网络变化,都是难以维护的。这可能意味着要实现更复杂的容错。
- 拉取(Pull):当有 worker 空闲的时候通知 coordinator,再由 coordinator 将任务分配给该 worker。
- 它天然实现了负载均衡(任务分配由 Worker 的处理速度驱动,而不需要 Coordinator 进行计算)。降低了 Coordinator 对 Worker 状态的依赖性。
因此,我们采用 Pull 的方式进行任务分配。但问题是:
- “任务”在代码里是如何表达的?
- Worker 是如何通知 Coordinator 的?Coordinator 是如何进行任务分配的?
“任务”如何被表达?
任务的定义
由于“任务”是全局性的,Coodinator 需要维护每个任务的状态,而 Worker 只需要知道当前任务的信息就足够了。因此“任务”的定义是在 coordinator.go 中实现的。
于是,我们观察 coordinator.go,会发现它包含:
- Coordinator 结构体
- Coordinator 结构体的方法
- MakeCoordinator 函数:用于创建 Coordinator 对象,并执行相关操作
可以理解为:结构体对象用于存储数据与维护状态、结构体对象的方法用于执行动作、函数用于编排流程。
在结构体对象中,我们要存储和维护所有任务的列表:
//其中mu、MapCount、ReduceCount都是后来定义的,在这个阶段,我只定义了Tasks
type Coordinator struct {
	mu          sync.Mutex //互斥锁,保护所有字段
	Tasks       []Task
	MapCount    int // 未完成的 Map 任务数
	ReduceCount int // 未完成的 Reduce 任务数
}
对于每个任务,无论是 Map 任务还是 Reduce 任务,都有一致的结构和状态。因此我们再定义 Task 类型结构体:
//Task类型的定义同样是我在实现的过程中慢慢修改,不断完善的。比如AssignedAt字段是我在写容错阶段的代码时才加上的。
type Task struct {
	TaskID     int
	TaskType   TaskType
	Status     TaskStatus
	FileName   string
	NReduce    int       //Map任务需要知道NReduce才能将键值对分配到对应的哈希桶
	AssignedAt time.Time //任务分配时间
}
最初我考虑过用 MapTask 和 ReduceTask 两个不同的结构体。但它们有大量的代码冗余,且在 Coordinator 眼里,Map 任务和 Reduce 任务本质上都是一个“需要被分发、跟踪超时、等待完成的有限状态机”。
任务的创建
自然的,我们要接着考虑把数据存入 Coordinator 中。即创建任务。代码逻辑如下:
- 初始化任务列表(即切片)
- 这里我用的初始化方法是
s := make([]T, 0, 100),即声明时指定长度和容量。这是工程上的最佳实践。
- 这里我用的初始化方法是
- 给每个输入文件创建一个 map 任务
- 创建 nReduce 个 reduce 任务
任务分配如何进行?
Worker 是如何通知 Coordinator 的?Coordinator 是如何进行任务分配的?由于 Worker 和 Coordinator 是不同的进程,所以任务分配,实则是进程间通信问题。
进程间通信问题,包含单机内进程通信,和跨网络节点通信。
- 单机内进程通信的方法用于同一台物理机上不同进程之间交换数据。主要通信方式有:管道、信号、消息队列、共享内存、信号量、内存映射文件。
- 跨网络节点通信的方法,用于进程分布在不同机器时。主要通信方式有:套接字(Socket)、远程过程调用(RPC)、消息队列(MQ)、REST/HTTP 等
选择合适的跨网络节点通信方法,需要经过以下几步:
- 判断通信本身的特性
- 根据通信特性来选择技术路线
- 根据场景和需求来选择该技术路线下的具体技术方案。
最简单的方式是从场景推出适用的方案,目前业界对已有的场景都有经验性的最佳方案,比如内部微服务互相调用的场景用 gRPC、给第三方开放 API 用 REST/HTTP、实时聊天/协作用 WebSocket...
但如果先考虑特性,那么在面临一个具体场景的时候,你会先去考虑这个场景背后的通信本质。这能帮助你理解为什么要选择这种方案,而不选其她方案。
通信技术的选型取决于通信的特性(只列出部分起决定性作用的特性)。
- 网络拓扑:点对点 / 一对多(一对多几乎必然要引入消息中间件,无法直接使用直连协议)
- 消息流向:请求 - 响应 / 单向 / 双向
- 时间耦合:同步(调用方发出请求,阻塞等待响应) / 异步(调用方发出消息后继续执行,响应通过回调/事件到达)
点对点拓扑的通信可以是同步、也可以是异步的;一对多的通信必然是异步的
根据通信的特性,确定技术路线。即“用哪类方法解决通信问题”。
| 技术路线 | 网络拓扑 | 消息流向 | 时间耦合 |
|---|---|---|---|
| 直连调用 | 点对点 | 请求 - 响应 | 同步 |
| 服务端推送 | 点对点 | 单向(服务端→客户端) | 异步 |
| 客户端上报 | 点对点 | 单向(客户端→服务端) | 异步 |
| 双向通信 | 点对点 | 双向 | 异步 |
| 消息队列 | 一对多 | 单向 | 异步 |
确定了技术路线后,再进一步根据场景、需求来确定技术方案。
| 技术路线 | 具体技术 | 层次 | 备注 | 常见场景 |
|---|---|---|---|---|
| 直连调用 | REST/HTTP | 应用层 | 对外,资源导向 | 对外开放 API、第三方集成 |
| 直连调用 | RPC(net/rpc、gRPC Unary) | 应用层 | 对内,行为导向 | 内部服务间调用 |
| 服务端推送 | SSE | 应用层 | 浏览器兼容好 | 通知推送、AI 流式输出 |
| 服务端推送 | gRPC Server Streaming | 应用层 | 对内 | 内部服务的持续数据推送 |
| 客户端上报 | gRPC Client Streaming | 应用层 | 对内 | 批量数据写入、文件上传 |
| 客户端上报 | UDP Socket | 传输层 | 允许丢失 | 日志采样、指标上报 |
| 双向通信 | WebSocket | 应用层 | 通用 | 实时聊天、协同编辑 |
| 双向通信 | WebRTC | 应用层 | 需要 NAT 穿透 | 音视频通话、P2P 传输 |
| 双向通信 | gRPC Bidi Streaming | 应用层 | 对内 | 内部服务双向流 |
| 双向通信 | TCP Socket | 传输层 | 自定义协议 | 游戏服务器、数据库连接 |
| 消息队列 | Kafka | 应用层 | 高吞吐、持久化 | 事件流、日志收集、削峰填谷 |
| 消息队列 | MQTT | 应用层 | 轻量、低带宽 | IoT 设备上报 |
跨网络通信属于计算机网络范畴,根据我们所学知识,计算机网络分为五层(将标准 TCP/IP 模型底层的网络接口层拆分为两个层),分别是物理层、数据链路层、网络层,传输层,应用层。跨网络的通信方案,实则就是操作传输层或应用层的数据。操作数据是通过该层所暴露的接口实现的。
- 选应用层(HTTP/gRPC/WebSocket/...):开箱即用,代价是接受它的抽象和约束。向程序员暴露各自的库/框架接口(如 net/http、grpc.Dial)
- 选传输层(TCP/UDP):自己控制连接、序列化、协议设计,灵活但要自己实现很多东西。向程序员暴露 Socket API(由操作系统提供)
- Socket 是传输层的接口,应用层的库(HTTP 库、gRPC 库)底层也是在用 Socket,只是封装掉了。
一般情况下,我们会先假设使用应用层方案。如果应用层方案没有与自己的需求匹配的,需要自定义协议或者极致的性能,那再考虑传输层
RPC 是编程模型,不是具体技术。各语言有自己的实现(Go 的 net/rpc、跨语言的 gRPC 等)
Coordinator 和 Worker 通信发生在以下两个情境:
- Worker 向 Coordinator 请求任务,Coordinator 返回任务
- Worker 完成任务后告知结果,Coordinator 无需响应
它的通信特性是点对点、请求 - 响应、同步。我们选择直连调用的技术路线。这种技术路线下,可以选择的技术方案有:RPC 和 REST/HTTP。REST 把系统抽象成一组可操作的资源,RPC 把系统抽象成一组可调用的函数(即一组行为)。MapReduce 的通信语义是行为上的,比如“申请分配任务”、“告知任务已完成”,如果用资源来表达会产生错配,因此我们采用 RPC 的技术方案。
go 语言中,RPC 有多种实现,它们有相同的通信特性,但有不同的工程实现。
net/rpc:标准库,不需要外部依赖,实现简单,不支持跨语言。gRPC Unary:实现复杂,性能更强,适合生产级服务
gRPC 有四种模式,其中 gRPC Unary 是 RPC 模型的直接实现,其她三种模式是 gRPC 借用了 RPC 的接口定义能力,但超出了 RPC 概念所定义的边界。
在实验中,我们的主要目的是实现逻辑而非关注通信细节,net/rpc 让我们把重心放在把设计工程化上。
net/rpc 中,通信的实现步骤
- 定义消息结构:用 Go 结构体定义请求和响应的数据结构。
- 编写服务端处理方法:编写业务逻辑,方法签名必须满足
net/rpc的约定:
func (t *T) MethodName(args *ArgsType, reply *ReplyType) error
net/rpc 并没有在源码里定义一个 interface,没有具体的接口定义。它的做法是在注册时通过反射扫描,找出所有满足此约定的方法,将其注册为可远程调用的方法。
- 注册并启动服务端:将对象注册到
rpc.Server,监听连接等待连接。
- 多台机器上,一般选择监听 TCP 端口等待连接;但由于实验是本地进行,采用的是 Unix Domian Socket 本地通信,不占用端口,避免多进程并发测试时端口冲突
- 客户端建立连接并调用:用
rpc.Dial/rpc.DialHTTP连接到服务端,通过Call方法发起同步调用,传入方法名、请求和响应指针,阻塞等待结果返回。
- RPC 支持短连接和长连接。实验中采用的是短连接,每次 RPC 都 DialHTTP + Call + Close
RPC 能够让 Worker 像调用本地函数一样调用远程方法。在任务分配时,Worker 调用 Coordinator 的 AssignTask 方法,Coordinator 在方法内选择一个任务填入响应结构体,返回给 Worker。
实验中,注册并启动服务端这一步在已经被封装进 server方法,无需实现;客户端连接服务器、发起调用的具体细节也被封装进call 函数,无需实现;
我们只需实现:
- 定义消息结构(
rpc.go中的请求/响应参数结构体:Args/Reply) - 服务端(Coordinator)处理方法(
AssignTask方法) - 客户端 (Worker) 调用时传入的方法名、请求和响应
1.定义消息结构
通信实现的是:Coordinator 将任务分配给 Worker。因此传输的消息如下:
- 请求参数为空,Worker 发送消息意味着它处于空闲状态,可以接收任务
- 响应参数为一个具体的任务。Coordinator 选择一个任务交付给 Worker
type AssignTaskArgs struct {
}
type AssignTaskReply struct {
	Task Task
}
2.Coordinator 分配任务
接下来,一旦有 Worker 调用 AssignTask(即向服务端 Coordinator 发起通信),Coordinator 会分配一个未完成的 Map 任务给它(作为响应参数)。代码逻辑如下:
- 如果还有 Map 任务没有完成,先分配 Map 任务
- 循环找到一个未分配的 Map 任务。如果所有 Map 任务都分配完,则给 Worker 分配一个空任务
- 所有 Map 任务完成后,再分配 Reduce 任务
- 循环找到一个未分配的 Reduce 任务。如果所有 Reduce 任务都分配完,则给 Worker 分配一个空任务
- 如果全部任务都已完成,则返回关闭任务
任务全都分配完,并不等于任务全都已完成
这里需要注意两点:
- 判断 Map 任务或 Reduce 任务是否已全部完成,需要用计数器。因此我在 Coordinator 类型结构体中定义了
MapCount和ReduceCount。 - 在选择具体的任务进行分配时,需要修改任务的状态(从空闲状态改为运行状态),涉及写操作。因此在
AssignTask中,同一块内存会被多个 goroutine 并发访问,且存在写操作,我们需要对共享数据加锁
如果整个函数体都是临界区,则可以在函数开头加锁:
c.mu.Lock()         //加锁
defer c.mu.Unlock() //解锁
如果函数中只有一部分代码是临界区,则可以手动加锁解锁:
c.mu.Lock()         //加锁
//临界区代码
c.mu.Unlock() //解锁
3.Worker 请求任务
前面提到,实验已经把调用细节封装进 call 函数中,我们只需要传入方法名、请求和响应参数,就可以实现通信。
worker.go 中已经给出了请求调用的实例代码 CallExample,模仿它写一个真实的请求分配任务的代码即可。
func getTask() (Task) {
	var args AssignTaskArgs
	var reply AssignTaskReply
	ok := call("Coordinator.AssignTask", &args, &reply)
	if !ok {
		return Task{}
	}
	return reply.Task

}
在主函数逻辑中,一个 Worker 的生命周期是:
- 空闲
- 无限循环请求分配任务(每次循环
getTask一次)- 分配到 Map 或 Reduce 任务
- 调用对应的任务执行函数(
mapTask/reduceTask) - 执行完毕,通知 Coordinator(我把这部分的代码放在了任务执行函数内部,因此目前阶段无需实现)
- 调用对应的任务执行函数(
- 分配到空任务,等待一段时间后重新请求
- 分配到关闭任务,Worker 退出进程。
- 分配到 Map 或 Reduce 任务
因此主函数里写一个循环,每次循环 getTask 一次,接着根据不同任务类型来处理任务。
阶段二:Map
这一阶段,我们要写的是 worker.go 中的 Map 任务执行函数,即mapTask。
根本差异在于:实验假设数据可以全部转入内存,而在工程实现中,假设数据远超于内存容量。
mapTask应该要先把 Block 数据块解析为键值对,以偏移量的形式传给 Map 函数(因为同一个文件可能会被切分为多个 Map 任务)。但由于实验中的 Map 函数简化了,所需参数为文件名,因此跳过这一步。- 在真正的分布式实现(如 Hadoop)中,为了支持海量数据,Map 函数会通过
emit逐条将中间结果交给框架,而不是一次性返回整个列表。而实验简化了这一步,让 Map 全量返回所有的中间键值对。正是因为这一步的差异,导致实验中mapTask的实现和原始设计中的实现截然不同。
- 工程实现中,由于海量数据 ->必须使用流式
emit->引入了内存缓冲区 ->达到阈值后溢写 ->每次溢写时进行分区和局部排序 ->产生多个溢写文件 ->最终对多个溢写文件进行多路归并排序 - 在实验中,从第一步就断开了,因此我们需要独立推导符合实验要求的流程。不过虽然实现的时机存在巨大差异,要达成的目的是一致的:获取中间键值对、对其分区与排序、写入中间文件。
- 根据文件名读取文件内容,将它们作为参数传入 Map 函数,获得中间键值对
kva(key-value array) - 对中间键值对排序 + 分区
- 将中间键值对存入 mr-X-Y 文件(一个分区对应一个中间文件)
- 通知 Coordinator 任务已完成。
第一步的实现十分简单,我们讨论步骤二、三、四的实现。
排序与分区
我们已经拿到了该 Map 任务的全量中间键值对(即切片变量 kva),存储在内存中。
对于中间键值对,可以采取两种方案:
假设中间键值对总数为 N,分区(Reduce)数量为 R,且数据均匀分布。
- 先全量排序再分区。排序的时间复杂度为
O(N logN),分区的时间复杂度为O(N),总时间复杂度为O(N logN) - 先分区再局部排序。分区时间复杂度为
O(N),排序的时间复杂度为R * O((N/R) log(N/R)),总时间复杂度约为O(N log(N/R))
因此,mapTask 中这一部分的实现逻辑如下:
- 遍历全部中间键值对,对其进行分区,存入对应的
buckets[i] - 遍历每个 buckets,对桶内的切片调用
slices.SortFunc进行排序。(采用这种排序方法的原因见Go语言:从排序功能看接口、反射、闭包、泛型)
写入中间文件
目前为止,我们得到了各个分区的有序数组 buckets[i]。要将数据写入文件,有许多种方法,应该如何决策呢?
- 数据表示和序列化,即“数据存成什么格式?”。具体来说,它关注内存中的 Go 对象(如结构体、切片)如何转换为二进制字节流(
[]byte)。只负责数据的物理表达和结构还原,不关心数据最终是写入文件、还是发向网络。
- 序列化为文本字符流。根据“如何划分字段”,由分为两种不同的策略:
- 结构化标记流(JSON、XML)。通过显式的语法标记(如
{}、<>)来定义数据结构。自带层次结构、提供自动转义机制。 - 扁平分隔流(如 CSV、自定义格式)。通过固定的位置或分隔符来切分字段。轻量、解析快,但需要手动实现复杂的特殊字符处理逻辑。
- 结构化标记流(JSON、XML)。通过显式的语法标记(如
- 序列化为二进制流。它的序列化速度最快、体积最小,但不支持文件追加,人类不可读。
- I/O 调度与刷盘策略,即“字节流怎么写进磁盘?”。它关注的是,拿到序列化后的字节流后,以什么方式向操作系统发起
sys_write系统调用。
- 一次性写入(
os.WriteFile),适用于数据量不大的场景。有 OOM,即内存溢出风险 - 标准写入(通过
os包打开或创建文件,获得文件对象后再进行操作。),灵活可控,适用于大多数场景。写 1 个字节就触发 1 次sys_write,CPU 频繁在用户态和内核态切换。 - 缓冲写入(
bufio.Writer),适用于大文件或高频写入。先在内存bufio里开辟一块缓冲区(如 64KB),攒满一块再一次性发起sys_write
序列化本质上是把分散的数据组织成内存上连续的数据。
高级数据结构在内存中的存放方式通常散落在各处。例如在 Go 语言中定义一个结构体:
type Student struct {
    ID   int
    Name string    // string 本质是一个指针 + 长度,指向堆内存的另一块区域
    Tags []string  // slice 本质是一个指针 + 长度 + 容量,指向堆内存的又一片区域
}
当我们实例化这个结构体时,它在内存中的实际物理布局是:
[ 内存地址 A ] Student 结构体主体 (包含 ID,以及指向 Name 和 Tags 的指针)
     │
     ├───► 指向 ───► [ 内存地址 B ] Name 的真实字符串数据 ("Alice")
     │
     └───► 指向 ───► [ 内存地址 C ] Tags 的切片底层数组 ("Math", "CS")
-
物理状态:这些数据通过内存地址(指针)相互关联,但在物理内存芯片上,地址 A、B、C 可能相隔极其遥远。
-
指针(Pointer)只在当前的进程内存空间里有效。如果你把包含指针的内存直接发给另一台机器,或者写进磁盘,另一个进程读取时,那个指针地址(如
0x7fff5fbff410)在它的内存里要么是无效垃圾数据,要么直接导致程序非法访问 Segmentation Fault 崩溃
序列化的过程,本质上就是一次深度优先遍历。它顺着指针去找到分散在内存地址 A、B、C 的数据,然后剥离掉地址/指针,将真实的数据按照特定的协议顺序,挨个复制到一块新开辟的、连续的内存区域(即 []byte 切片)中。
[ 序列化后连续的内存空间:[]byte ]
┌──────────┬─────────────┬─────────────────┐
│ ID: 1001 │ Name: Alice │ Tags: Math, CS  │
└──────────┴─────────────┴─────────────────┘
 (首尾相连,没有指针,不依赖任何特定内存地址)
只有变成连续的 []byte,才能拥有以下两个特性:
- I/O 刷盘与传输能力。
- “可反序列化”的能力。因为数据在连续空间里是按既定顺序排布的,接收方才能顺着这块连续内存的开头逐字节往后读,重新在自己的内存里重新分配地址,把数据还原(Unflatten)回原来的树状或图状结构。-
如果追求极致性能,序列化为二进制格式是最佳的选择。但人类不可读。而实验中,我们需要查看中间文件来进行调试,最终输出文件也要求是人类可读的格式以通过测试。因此,我们只能为序列化为文本字符流。
由于我们编写的是通用的框架,用户输入的文件是不可控的,文件中可能存在 \n、Tab 键等特殊字符。牺牲部分性能,获取代码的健壮性与稳定性,在实验中是合理的选择。因此我们最终采取的序列化方案是 JSON 格式。在 Go 语言中,使用 json.NewEncoder 和 json.NewDecoder 方法(即 Go 标准包 encoding/json)
此外,由于我们处理的是大量数据,应当选择缓冲写入的方式。
encoding/json 与缓冲读写
- json.Encoder 内部实现的缓冲并不是为了减少系统调用而设计的,它的作用是保证“原子性”,即序列化出一个 JSON 对象到内存,再一次性调用
Write()将整个对象写入io.Writer。因此如果有 N 个中间键值对,那就会调用 N 次Write(),我们需要手动实现缓冲写。 - json.Decoder 内部自带缓冲读。它内部通过
bufio.Reader维护了一个缓冲区,从底层的io.Reader中预读数据。因此无需手动实现缓冲读。
通知 Coordinator 任务已完成
Map 任务完成后,需要发起 RPC 通知 Coordinator 任务已完成。
- Worker 新增一个
doneTask函数,用于发起 RPC - Coordinator 新增一个
DoneTask函数,找到对应已完成的任务,标记其已完成,并修改对应任务的计数器(计数器需要添加锁)。
阶段三:Shuffle、Sort 与 Reduce
当所有 Map 任务完成后,才会开始这一阶段,
worker 从 Coordinator 获取任务,如果任务类型是 Reduce,reduceTask 函数要完成的任务是:
- 从各个中间文件中读取自己分区的数据。
- 将多个中间文件中的数据进行排序,局部有序变成全局有序。
- 按 key 分组,并将分组结果依次传入自定义的 Reduce 函数,获取 key 值对应的结果
- 所有结果写入最终文件
Map 阶段生成的每个文件都是有序的,因此对于第一步、第二步,实则完成的是同一个目标:将 N 个有序的小文件,合并成 1 个全局有序的大文件。这是多路归并问题。
- 打开所有文件:同时打开 N 个中间分区文件,为每个文件创建一个
json.Decoder(流式读取)。 - 初始化堆(Heap):从每个已排序的文件中读取第一条记录,将这些记录放入一个最小堆中(按 Key 排序)
- 从堆顶弹出最小的记录,输出该记录。
- 从该记录来源的文件中读取下一条记录,推入堆中。
- 如果该记录来源文件没有下一条记录了,则关闭该文件。堆的大小会 -1
- 重复步骤 3,直到所有文件的所有记录都被处理完毕。
在实现多路归并的过程中,我们发现,每次弹出的记录是有序的,也就是 key 值相同的键值对会接连弹出。因此,我们可以在归并的同时,直接进行分组、reduce
因此整个 reduceTask 函数的流程为:
- 【初始化】匹配并打开所有中间文件,为每个文件创建一个 json.Decoder,用于逐行读取 JSON 格式的键值对
- 【初始化】创建一个小根堆(优先队列),进行堆初始化(所有文件的第一个键值对入堆)
- 【初始化】创建临时输出文件 mr-out-{TaskID}.tmp* 与缓冲写入器。(最终输出文件将通过原子重命名生成,以避免写入过程中因程序崩溃而留下不完整文件。)
- 【初始化】维护一个 groups,用于暂存当前正在处理的同一 Key 的所有 Value。
- 循环归并与分组:循环执行以下操作,直到堆为空:
- 弹出堆顶元素:从堆中弹出 Key 最小的记录(当前所有文件中最小的一条)。
- 判断 Key 是否变化:
- 若当前 Key 与 groups.Key 不同,说明上一分组已完整,调用 reducef 处理该分组,将结果写入输出缓冲区,然后重置分组为当前 Key。
- 若相同,则将当前 Value 追加到 groups.Values 中。
- 补充下一行数据:从该记录来源的文件中尝试读取下一行键值对。若读取成功,则将其重新推入堆;若遇到 io.EOF,则关闭该文件并不再补充新元素(堆大小会随之减少)。
- 【收尾】处理最后一个分组
- 【收尾】所有分组处理完成后,将缓冲区中的剩余数据写入磁盘,然后关闭临时文件。
- 【原子提交】将临时文件重命名为最终文件
mr-out-{TaskID}。 - 向 Coordinator 报告任务已完成。
- 如果 Map 中间文件写入失败,遗留一个不完整的中间文件在 Worker 本地。Coordinator 能够检测到任务失败,重新调度该任务到另一个 Worker。Reduce 读取中间文件时,只会从成功执行 Map 任务的 Worker 磁盘上读取数据。
- 如果 Reduce 的文件写入失败,遗留一个不完整的最终文件在全局文件系统(GFS)中。Coordinator 能够检测到 Reduce 任务失败并重新调度,但在这之前,不完整的最终文件还未被覆盖,它可能被用户或测试脚本读取。
encoding/json 库:全量读取文件和流式读取文件
encoding/json 库提供了两套 API,分别是全量读取文件和流式读取文件(json.Unmarshal / json.NewDecoder+Decode)。
- 如果选择全量读取,内存占用≈文件大小的字节切片 + 反序列化后的目标变量(≈文件大小),即两倍的文件大小。
- 如果选择流式读取,内存占用=解析器内部的缓冲区大小(约 4KB)+ 当前正在解析的单条业务变量
阶段四:收尾
当所有任务结束后,MapCount和 ReduceCount都为 0。mrcoordinator周期性调用Done() 了来判断 Coordinator 任务是否已经完成。
横切关注点
日志
log/slog 还是 fmt.Println?
fmt.Println:是面向用户的交互与标准输出。常用于向终端用户打印提示信息、帮助文档、操作结果等。log/slog:是面向系统的运维与诊断。
因此,如果是临时排查,写完就删,则用 fmt.Println。如果是长期保留,需要在不同环境切换控制日志输出,则用 log
log 还是 slog?
- 传统
log是纯文本输出。如果要收集日志中的数据用于统计,需要写复杂的正则表达式。它不带日志级别,只能通过特殊函数来控制程序(可以决定打印日志后是否要退出程序)。 slog是键值对格式。它自带日志级别,且所有数据都是明确的键值对。
日志级别是控制日志输出的重要手段。通过设置不同的日志级别,我们可以灵活地控制日志的详细程度。在 Go 语言中,常见的日志级别有 DEBUG、INFO、WARN、ERROR 和FATAL。不同级别的日志用于记录不同类型的信息,例如:
DEBUG:用于记录详细的调试信息,仅在开发环境中启用。例如变量、函数入参等INFO:用于记录正常的业务流程信息,例如服务启动、配置加载、任务完成、请求的处理、数据的加载等。WARN:用于记录可能存在的问题或异常情况,但不影响系统的正常运行。例如用户输入了非法参数、限流触发、某个请求超时但已重试。ERROR:用于记录严重的错误信息,这些错误可能导致系统无法正常运行。例如数据库连接端口FATAL:用于记录非常严重的错误信息,这些错误会导致程序立即退出。
我在项目中采用 slog 进行日志打印,效果如下: 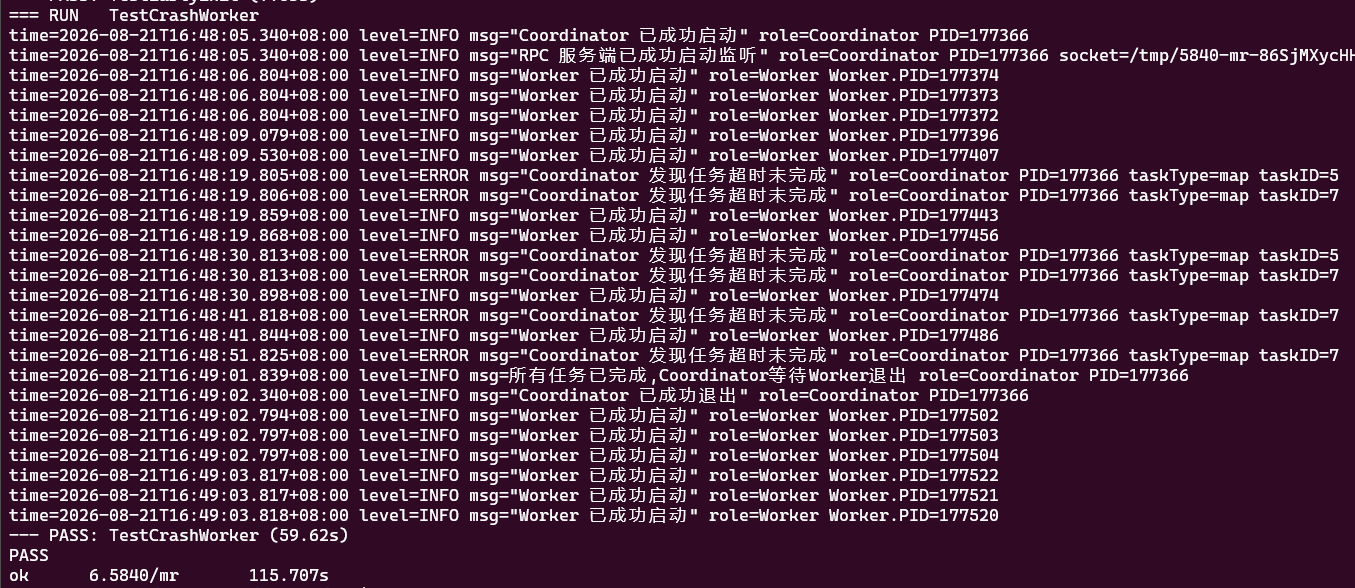
最初,coordinator 和 worker 运行后,控制台没有任何输出,我不知道这些进程正在做什么,卡在哪一步。因此,我需要添加日志,来确认每个进程都在正常运行。
由于课程的要求:
- 输出结果要干净
- 不能修改 main 函数所在的文件
因此,我把 logger 的初始化放在了 coordinator.go 和 worker.go 的入口。并且通过设置 slog.HandlerOptions 来一键显隐不同的日志等级(非常好用!)
由于我需要进行多进程的监控,因此我初始化了一个带有 PID 的 logger。
//初始化logger
func initLogger() {
	handler :=slog.NewTextHandler(os.Stdout, &slog.HandlerOptions{
		Level: slog.LevelDebug})
	logger := slog.New(handler).With("Coordinator.PID", os.Getpid())
	//设置为全局默认Logger
	slog.SetDefault(logger)
	slog.Info("Coordinator 已成功启动")
}
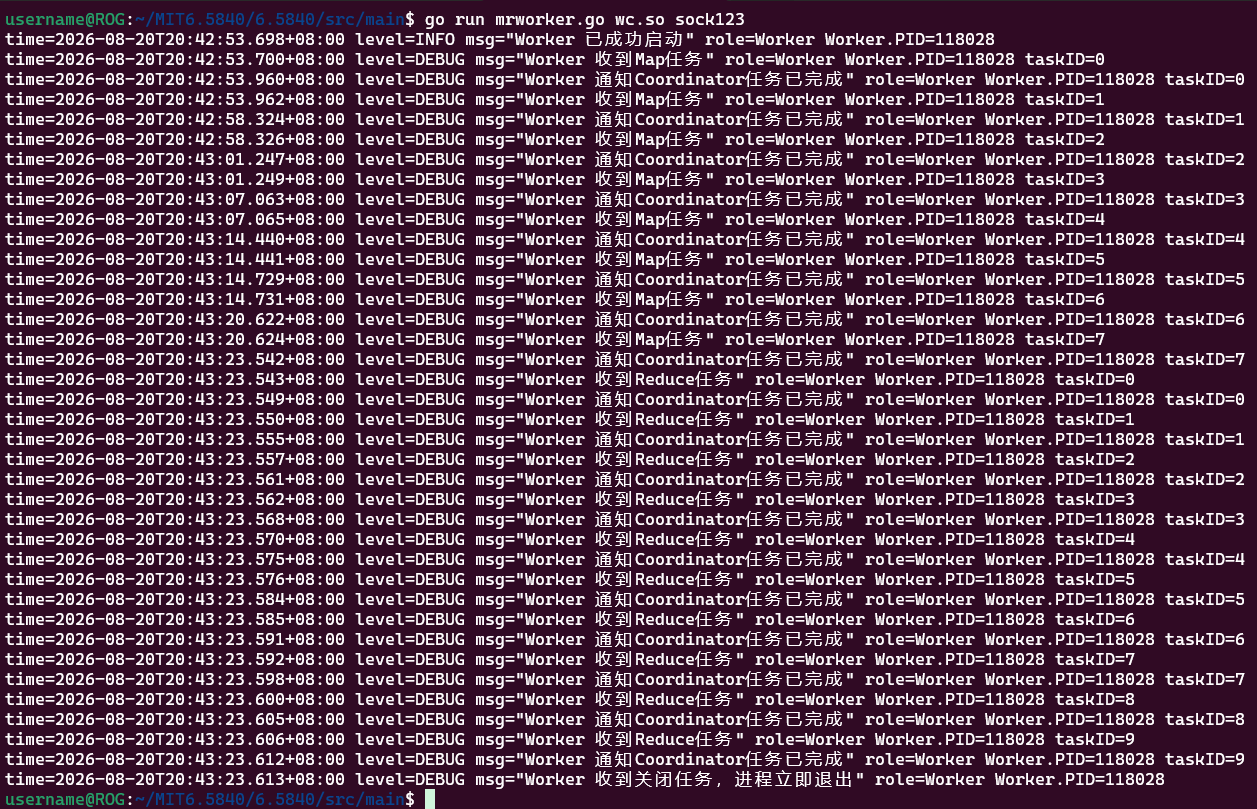
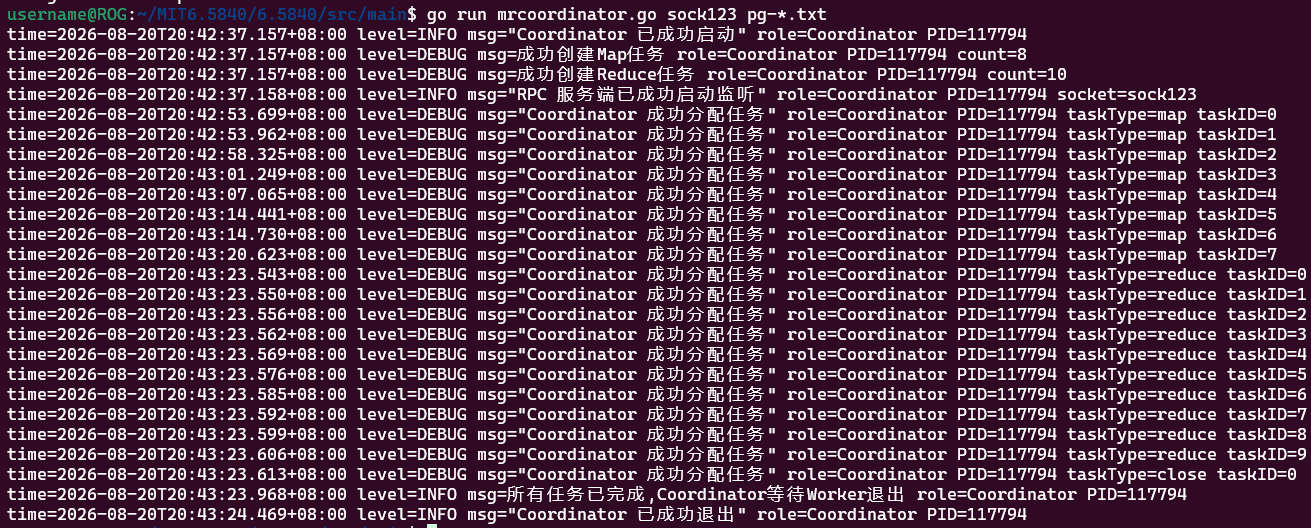
运行 Coordinator 和 Worker,输出日志如下:
Worker 进程:
Coordinator 进程
并发控制
根据日志输出可知,代码能够实现基本的流程。但在 makr mr 后,出现 DATA RACE 报错。
报错指出:main 协程在调用 Coordinator.Done() 读取数据时,RPC 协程(Goroutine 28)正在调用 Coordinator.DoneTask() 修改数据,且两边没有加锁互斥,访问了同一个内存地址(0x00c000210198)。
因此,我虽然完成了基本的业务逻辑代码,但没有做好临界区的处理。那么有哪些需要处理的临界区变量?
- Coordinator 和不同 Worker 所处的进程空间不同,它们不会访问同一个内存地址。
- 单个 Worker 内部所有的任务处理都是线性的,也无需处理。
- Coordinator 内部,同一时间会启动多个协程
- main 在循环执行 Done() 时,读 MapCount 和 ReduceCount
- http.Serve 由 main 函数显式调用,会常驻内存,
- 每个 RPC 请求都会调用一个 gorotine 来跑对应的函数。如果有 N 个 Worker 同时发起任务分配请求,M 个 Worker 通知 Coordinator 任务已完成,则会有 2+M+N 个协程运行。
| 对比维度 | 互斥锁 (sync.Mutex / RWMutex) |
通道 (Channel) |
原子操作 (sync/atomic) |
单例执行 (sync.Once) |
|---|---|---|---|---|
| 设计理念 | 保护临界区数据 | 控制协程间的通信、执行顺序 | 由硬件保证操作的原子性 | 保证函数有且只执行一次(无论多少 goroutine 调用了它) |
| 适合场景 | 多字段关联状态机、复杂结构体(如 Map/Slice/对象缓存) | 协程间任务分发、数据所有权转移、事件异步通知/超时控制 | 无关联的单一数值(如请求计数器、状态标志位、指针替换) | 延迟加载、全局配置加载、数据库连接池初始化 |
| 性能开销 | 低 | 中 | 极低 | 极低 |
| 风险 | 容易死锁(忘记 Unlock、锁嵌套);粒度过大影响并发 | 容易阻塞死锁、Channel 泄漏、向已关闭的 Channel 写数据导致崩溃 | 无法保证“组合逻辑”的原子性(如先读再修改字段) | 初始化函数内部若崩溃/panic,不会重新执行 |
为了防止多个协程同时读写计数器、修改任务状态。我们需要给 Coordinator 实例加上互斥锁。对数据进行读写时,都需要加锁
type Coordinator struct {
	mu sync.Mutex   //互斥锁,保护所有字段
	Tasks []Task
	MapCount int
	ReduceCount int
}
例如在分配任务时:
func (c *Coordinator) AssignTask(args *AssignTaskArgs, reply *AssignTaskReply) error {
	c.mu.Lock()         //加锁
	defer c.mu.Unlock() //解锁
	...
}
容错处理
TestJobCount 测试失败
- 在我最初的设计中,只要有 worker 请求任务,且存在未完成的任务,那么 worker 就能领取到任务,即使这个任务没有超时。这样能够天然实现负载均衡(1.分配一个未完成的、类型为 t 的任务;2.如果全都分配完,但是仍有任务未完成,则分配一个已分配时间最长的任务给 Worker)。但是这无法通过
TestJobCount测试。实验的要求是:如果任务已分配,未超时,那么它就不能被分配给其她 Worker- 从功能性角度上来说,我的逻辑是正确的。但这是一种激进的重试。标准的推测执行是只在拖后腿的任务上启动备份,用少量冗余计算换取总执行时间的缩短,整体资源开销小;我的执行会耗费大量的计算资源和网络带宽,造成 CPU 和内存的浪费。
- 因此,我需要修改分配的逻辑,Coordinator 只能分配空闲任务;并开一个协程,来定期检测各个任务是否超时未完成,超时的运行中任务的状态设置为空闲,
在 MapReduce 中,两个 worker 同时执行同一个 map 任务主要发生在以下两种场景。
- 推测执行(优化速度。并发执行)。由于机器负载不均、硬件老化或网络延迟等,一个作业中的某些任务可能远慢于其他任务,成为整个作业的瓶颈。为了避免这种情况拖慢整个作业,框架会为该任务启动一个备份任务
- 任务失败重试(确保可靠性。顺序执行)。这种重试是顺序的,即先等失败的任务结束后,再重新开始一个新任务。
| 特性 | 任务失败重试 (Fault-tolerance Retry) | 推测执行 (Speculative Execution) |
|---|---|---|
| 主要目的 | 保证可靠性:确保即使 Worker 故障,任务也能最终完成。 | 优化性能:为“拖后腿”的慢任务启动备份,加速整体进度。 |
| 触发条件 | 任务失败:Worker 崩溃、无响应或超过 10 秒未完成。 | 任务缓慢:任务仍在运行,但进度远落后于同类任务。 |
| 执行时序 | 先后执行:旧任务失败后,新任务才启动。 | 并行执行:备份任务与原始任务同时运行,先完成的被采纳。 |
| 在 6.5840 中 | 必须实现(核心要求)。 | 可选实现(实验不要求)。 |
在实验中要求超过 10 秒没有完成的任务即为超时。这是属于任务失败重试的情况。超过 10 秒没有完成这个任务,就可以视为这个 worker 已经崩溃了。这种情况下应该被归为容错,而不是性能优化。Coordinator 会把该任务的状态设置为空闲。
如果是推测执行及并行的情况,coordinator 会知道原来的 worker 是活着的并且正常,但它认为对方太慢了,所以会把这个任务分配给另外一个 worker,并且采纳最先返回的结果,然后主动通过 RPC 通知慢的那个 worker 放弃任务。
代码中的错误与调试
- 任务失败后,使用了
log.Fatalf来记录日志。log.Fatalf会指定os.Exit(1)来杀死进程。应该用slog.Error来打印错误日志,并用continue进入下一次循环来领取任务。 - 我使用
bufio.Write写文件,但是由于关闭文件前没有调用Flush()刷盘,因此缓冲区中残留的数据没有写入硬盘。导致我每个文件 s~z 的数据丢失。 - 如果使用 range 循环,要修改数组中的数据,则必须用下标来访问数据,而不是直接修改。比如:
for _, task := range c.Tasks{
	if task.TaskType == t && task.Status == Idle{
		task.AssignedAt = time.Now()  //这里的task仅仅是一个副本,并不会修改真正的task的值
		task.Status = Running
		return task
	}
}