MapReduce: simplified data processing on large clusters
MapReduce is a programming model and an associated implementation for processing and generating large datasets that is amenable to a broad variety of real-world tasks. Users specify the computation in terms of a map and a reduce function, and the underlying runtime system automatically parallelizes the computation across large-scale clusters of machines, handles machine failures, and schedules inter-machine communication to make efficient use of the network and disks. Programmers find the system easy to use: more than ten thousand distinct MapReduce programs have been implemented internally at Google over the past four years, and an average of one hundred thousand MapReduce jobs are executed on Google's clusters every day, processing a total of more than twenty petabytes of data per day.
相关笔记:
里程碑的定义是:重新定义了问题空间(转移范式)、划定了边界
- 里程碑论文是技术的主干,后续的创新大多是沿此衍生出的分支或对主干局限性的修正。了解主干能让我们发现技术是如何演进的。
- 里程碑论文中提出的概念/解决的痛点/遗留的问题往往是学术界的常识,最新论文默认我们已经掌握了这些基础。
- 里程碑论文中的思维不会过时:
- 如何定义问题?
- 如何约束和权衡?(在给定的边界条件下,做架构上的权衡)
- 如何设计实验来评估性能、或证明方案的正确性
不过,硬件假设和工程细节会变化。
总结
这篇论文面对的场景是对 TB/PB 级的全量数据进行批量计算,且数据之间相互独立,例如网页索引、日志统计。在这之前,大规模并行计算的主要方案是 MPI。MPI 面对的是科学计算场景——节点之间存在复杂的数据依赖和频繁的通信需求,这类计算任务无法被简单的高层抽象覆盖,所以 MPI 选择暴露底层原语,把控制权交给程序员。
这篇论文发现 Google 内部几乎所有的大规模数据处理任务,计算逻辑都可以被表达为两类操作:对每条数据独立处理(Map),和把相同 key 的数据合并(Reduce)。这是一个关键洞察,识别出一类问题的结构性特征,然后设计一个受限但自动化的框架来覆盖这类问题。
基于这个洞察,她们把所有计算逻辑限制为 Map 和 Reduce 两个无状态的函数,框架完全接管并行化、容错、调度的所有细节,让没有分布式系统经验的普通工程师也能在数千台机器上处理大规模数据。
她们选择了极度简化的编程模型,因此划定了 MapReduce 的边界:不适用于实时流处理、不适用于低延迟场景、不适用于数据之间存在复杂依赖的场景。
因为 MapReduce 是批处理方案,两个阶段是全量的,所以它不适用于实时流处理,也不适用于低延迟场景,因为编程模型只能表达 map 和 reduce 两个操作,数据之间存在复杂依赖的场景,无法被map和reduce两个操作进行表达。
阅读
前提与假设
场景假设(应用场景):
- 工作负载假设:输入数据量大 + 业务逻辑简单且独立。任务主要是扫描全量数据并生成派生数据(如倒排索引、日志统计),不要求毫秒级实时响应,只关注总吞吐量。
环境假设(运行在什么基础设施和故障模型下):
- 采用廉价且不可靠的商用集群,硬件故障是常态。
- 采用廉价 IDE 硬盘进行存储,底层依赖 GFS( Google 内部开发的分布式文件系统,该文件系统会把数据放在多个机器上进行备份。),数据以 64MB 块 存储于本地磁盘,每块默认 3 副本 冗余。
- 网络带宽是系统中最稀缺的资源瓶颈
- 非拜占庭式崩溃停机模型 (Fail-stop / Non-Byzantine Faults):系统仅处理机器无响应(Heartbeat/Ping 超时)或进程崩溃(Crash),不处理恶意篡改或静默数据损坏等拜占庭故障。
逻辑与数学假设:
- 用户函数假设:用户提供的
Map和Reduce函数是确定性的,即相同输入永远产生相同输出。 - 提交原子性依赖:输出正确性硬依赖底层文件系统的原子重命名(atomic rename) 机制。无此特性,则无法保证最终一致性。
方法设计
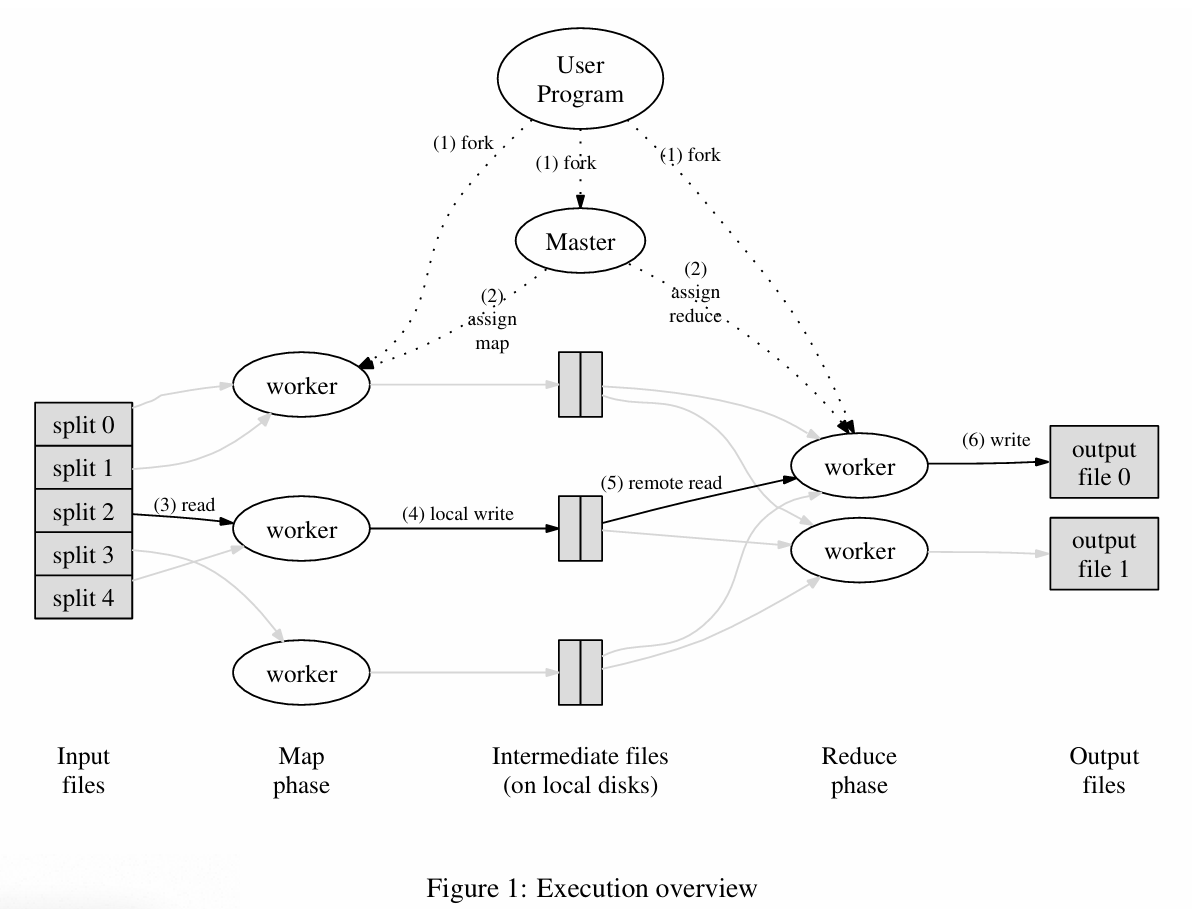
论文将一次 MapReduce 执行划分为 M 个 Map 分片和 R 个 Reduce 分区。以下是基于论文 图 1 和 第 3.1 节 的标准化执行流程:
这些流程直接来源于论文,更偏向设计的角度。在 MapReduce 设计流程 中,我会通过举例,以实现的角度出发,重新阐述各个阶段。
阶段 0:初始化与拆分(启动)
- 用户程序调用 MapReduce 函数,库自动将输入数据切分为 M 个数据分片(通常每个 16MB~64MB)。随后,系统在集群中启动多个 Worker 进程,其中一个是 Master(主控节点),其余为 Worker(工作节点)。Master 负责空闲 Worker 的调度,并维护 M 个 Map 任务和 R 个 Reduce 任务的状态。
阶段 1:Map 任务执行(数据读取与映射)
- 被分配 Map 任务的 Worker 读取对应的输入分片,解析出键值对(Key/Value),并调用用户定义的 Map 函数。Map 函数产生的中间键值对(Intermediate K/V)会先缓存在内存中。
阶段 2:分区与溢写(Partitioning & Local Write)
- 内存中的中间结果会周期性溢写(Spill)到本地磁盘。在写入前,系统会通过用户指定的分区函数(默认
hash(key) mod R)将数据划分为 R 个区域。溢写完成后,Worker 将这些本地文件的位置信息(元数据) 发送给 Master,由 Master 负责将这些位置转发给对应的 Reduce Worker。
阶段 3:混洗与排序(Shuffle & Sort)
- 当 Reduce Worker 被 Master 通知了 Map 输出的位置后,它通过远程过程调用(RPC) 从 Map Worker 的本地磁盘拉取属于自己的那部分中间数据。数据拉取完成后,Reduce Worker 对所有的中间键进行排序(若数据量过大则使用外部排序),将所有相同键(Key)的数值聚集在一起。
阶段 4:Reduce 任务执行(归约与输出)
- Reduce Worker 遍历排序后的中间数据。对于每一个唯一的 Key,它将该 Key 和对应的 Value 集合(通过迭代器传入)交给用户定义的
Reduce函数进行处理。Reduce 函数的最终结果会原子地写入到全局分布式文件系统(GFS)上的最终输出文件(每个 Reduce 任务生成一个文件,共 R 个文件)。
阶段 5:完成与返回
- 当所有 Map 和 Reduce 任务都完成后,Master 唤醒用户程序,MapReduce 调用结束。用户无需合并 R 个输出文件,因为它们可以直接作为下一次 MapReduce 任务的输入。
实验设计
作者是如何设计实验验证其方案的?使用了哪些 Benchmark、Baseline 和指标?
- 选取了两个 Benchmark:分布式 Grep 和分布式 Sort。
- 选取了两个 Baseline:
- 针对 Straggler::将 Backup Task(备份任务)机制关闭,观察尾部延迟(Straggler)对总耗时的影响
- 针对容错:在作业运行中期主动杀死 200 个 Worker 进程(约占总数的 11.4%),观察恢复开销
- 并未与第三方系统进行横向对比,而是将自身作为实验的对照组。通过开关关键特性和主动注入故障来验证系统的有效性。
Benchmark 是指实验对象;Baseline 是指比较对象。
由于论文篇幅有限,不可能枚举所有场景,所以作者选择了两个极端且对立的任务,证明系统在两个极端的资源瓶颈下都能跑的好:
- Grep(扫描类):I/O 瓶颈。几乎不占 CPU,不占网络,只测硬盘能读多快。用来证明“数据本地化”起作用了,能把硬盘读满
- Sort(排序类):网络 +CPU 瓶颈。所有数据都要重新打乱分发(Shuffle)。用来证明“网络调度”和“Combiner”起作用了
实现
评价
一、这篇论文在解决什么问题?
问题是从哪来的?
- 问题源自 Google 内部的实际工程困境。Google 的工程师们在过去 5 年中为了实现各种业务,编写了数百个专用的分布式计算程序。
这篇论文解决了什么问题?
- 如何在大规模的集群上,以一种简单且高效的方式处理海量数据(TB 级及以上),同时将复杂的分布式系统的细节(并行、容错、负载均衡等)对普通程序员完全屏蔽
为什么之前没人解决?
1.问题域的特殊性。
2003 年以前,分布式系统的出现并非为了处理 " 大数据 ",而是为了解决单机无法独立承担的若干根本性问题:
- 银行需要冗余与故障切换来保证高可用;
- 物理模拟、气候建模、基因组测序等科学计算的计算量远超单机上限,需要将任务分解到多个节点并行执行;
- 这是和 Google 场景最相似的问题域,同样处理大规模数据、计算任务同样是批处理的。但这类计算任务中,节点之间存在复杂的数据依赖和频繁的通信需求,无法用简单的高层抽象自动管理并发,程序员需要手动控制节点间的通信和同步。这正是 MPI 等框架追求通用性、暴露底层原语的根本原因。
- 企业级数据库则需要横向扩展来应对单台服务器无法承受的并发压力。
- 企业级数据库的横向扩展解决的是并发量大的问题。同一时刻有大量的用户在读写数据库,单台服务器的 CPU 跟 I/O 承受不住,所以需要多台机器分担请求。这个问题的本质是请求的数量多,而不是单次处理的数据量大。和 Google 属于不同问题域
Google 的场景是全新的。它的数据量以 TB/PB 计、需要对全量数据做批量计算、且任务本身并不复杂。
2.底层基础设施的历史积累
MapReduce 的高性能依赖于数据本地化调度:将计算任务派发到持有对应数据的节点,以避免海量的网络传输开销。而这一调度策略的前提,是 GFS(Google 的分布式文件系统)已经提供了块级别的数据位置信息。
值得注意的是,GFS 与 MapReduce 面对的是同一个问题域,两者几乎同期诞生于 Google 内部。换言之,在 MapReduce 出现之前,Google 已经为它量身建好了地基。真正解决这个问题域的,是 GFS 与 MapReduce 的组合,而非 MapReduce 单独完成的。
3.对问题的精准洞察,以及敢于做激进的 trade-off
Google 的核心洞察在于:她们面对的绝大多数大规模任务(网页索引、日志统计、倒排索引)在结构上高度同构。对一堆相互独立(互不依赖)的数据,每条数据做相同的变换处理,最后再把结果聚合。
我们对这两步进行命名,就产生了 map 和 reduce 两个操作:谷歌的大规模任务都可以以这种方式来表达:Map,然后 Reduce。
这一步实际上进行了编程模型的设计选择。当选择了只能用 map 跟 reduce 两种方式来表达时,就意味着已经放弃了编程模型的通用性,数据之间有依赖的任务,无法用这个框架来表达。
在顺序执行的情况下,一个任务是这样的:它对每条数据依次执行 map 任务,map 任务结束之后,再对所有中间数据依次执行 reduce。
但是,由于每条数据都是独立的、互不依赖的,所以它们可以并行处理。因此,我们可以将顺序执行的单机扩展为并行执行的分布式集群。集群中的每台电脑可以同时执行 map 任务,所有 map 任务结束之后,再对中间数据同时执行 reduce。
当我们从单机扩展为分布式集群的时候,业务逻辑(也就是 map 跟 reduce 中的逻辑)并没有任何改变。唯一改变的是,我们需要在这基础上增加分布式系统底层细节,比如容错、调度等等。
而对于不同的任务,它们仅仅是业务逻辑不同,分布式系统的底层细节却是完全相同的。因此,我们可以将这两部分进行分离,由框架负责底层细节,程序员负责 map 跟 reduce 中业务逻辑的书写。
这一步实际上进行了接口抽象层次的设计选择。分离之后,程序员虽然不需要负责底层细节,但这也意味着程序员无法再去干预这些底层细节了。
在这一小节里,引用块是我推理之后再额外加上的。我按照问题域的思路进行推理时,并没有思考过我在进行什么样的取舍。这是否意味着,当我在设计某一个系统的时候,并不需要以取舍的角度去看,而是以问题的角度去看呢?
- 是的。设计时以问题为起点,而非以取舍为起点。取舍是对设计的事后描述,问题域的结构特征才是设计的真正驱动力。当一个设计感觉理所当然的时候,往往意味着设计者真正理解了问题。反过来看,如果在设计过程中感到取舍是一件非常困难的事情,这意味着自己可能并没有清楚自己所面对的问题域是什么。
那我为什么要知道这个系统的取舍呢?考虑不同维度的取舍还有什么意义呢?
- 作为系统的使用者,只有清楚了系统的取舍,才能知道系统的边界和局限性。
- 作为系统的设计者。我们在理解 MapReduce 的时候,并不是为了去用它,而是为了站在它的肩膀上去思考下一步应该怎么做。只有知道 MapReduce 的取舍,我们才能找到下一步有价值的问题。
- 例如,在编程模型维度的取舍上,MapReduce 牺牲了通用性,那么我们能否修改编程模型,使得它支持更多的操作?(Spark 的出发点)
所以这篇论文的产生,关键之处在于:
- 问题产生的土壤,以及对问题的洞察
- 其她技术的突破,使得 MR 能够在此基础上创新
- 勇敢的 trade-off。
二、这篇论文的核心洞察(Key Insight)是什么?
核心洞察:Google 内部几乎所有的大规模数据处理任务,计算逻辑都可以被表达为两类操作:对每条数据独立处理(Map),和把相同 key 的数据合并(Reduce)。抽象地说:把复杂的并行问题归纳为少数几种操作模式,让框架自动处理并行和容错
这个洞察的迁移价值在于它背后更抽象的原则:识别出一类问题的结构性特征,然后设计一个受限但自动化的编程模型来覆盖这类问题。
- Spark:同样的洞察,但把操作模式从 Map+Reduce 扩展到任意 DAG 变换,覆盖了迭代计算场景
- SQL:把数据查询问题归纳为 Select、Filter、Join、Aggregate 几种操作,让数据库引擎自动处理执行计划和优化
- TensorFlow/PyTorch:把深度学习训练归纳为计算图上的前向传播和反向传播,让框架自动处理梯度计算和分布式训练
- Pregel:把图计算归纳为以顶点为中心的消息传递模式(BSP),让框架自动处理图的分布式执行
这些系统的共同点是:都找到了某类问题的结构性特征,用受限的编程模型覆盖这类问题,从而让框架可以自动处理底层复杂性。受限换自动化,这是 MapReduce 洞察最本质的迁移价值。
三、基于这个洞察,论文做出了哪些设计选择?
- 设计选择强调在一个具体的问题域中,在多个方向中选择了其中一个方向。
- 读论文的过程中,慢慢将关键设计选择补充进来,并判断它是核心设计选择 or 被核心选择约束的连锁选择 or 通用的基础设施选择。
- 结构为:主题 - 问题域:设计选择
核心选择
- 计算模型 - 编程模型:把所有计算逻辑限制为 Map 和 Reduce 两个无状态的纯函数,框架完全接管并行化、容错、调度的所有细节。
- 计算模型 - 处理时机:批处理。有界数据集上的一次性计算,必须等所有输入数据准备好才能开始处理。
连锁选择
- 计算模型 - 执行拓扑:线性两阶段结构(Map→Shuffle→Reduce),中间有全局屏障,所有 Map 必须完成才能开始 Reduce。
- 计算模型 - 状态管理:无状态。Map 和 Reduce 函数不依赖任何外部可变状态,中间结果通过本地磁盘传递给 Reduce。
- 计算模型 - 重计算:任务重试。无状态纯函数使得任何失败的任务可以直接在任意节点从头重新执行,不需要 Checkpoint。
- 容错 - 容错粒度:Master 节点故障直接终止整个作业,交由用户重新提交,不做自动恢复。Worker 故障则自动重试任务。
- 事务 - 原子提交:Map 任务完成后才向 Master 汇报临时文件名,Reduce 任务通过原子重命名保证输出文件要么完整存在要么不存在。这是无状态编程模型在容错场景下保证结果正确性的关键机制——任务重试不会产生部分结果。
基础设施选择
- 存储模型 - 持久化保证:直接采用 GFS,Map 的输入数据和 Reduce 的输出结果存储在 GFS 上。
- 网络通信 - 传输协议:直接采用 RPC,Master 与 Worker 之间同步通信。
- 调度与资源管理 - 调度架构:中心化单一 Master 调度器,追踪所有任务状态、分配任务、检测故障。
- 调度与资源管理 - 任务放置:数据本地性优先,把 Map 任务调度到存储对应数据分片的节点上,避免大量数据通过网络传输。
- 调度与资源管理 - 任务粒度:输入分片数量决定 Map 任务数,用户指定 Reduce 任务数 R。对慢任务启动推测执行(备份副本),用资源换时间。
- 容错 - 故障检测:Master 通过周期性心跳检测 Worker 存活,超时判定故障,重新分配任务。
- 分区 - 分区策略:Map 输出通过 hash(key) mod R 分配到 R 个 Reduce 任务,用户可自定义分区函数。
- 计算模型 - 编程模型(Combiner 优化):允许用户定义 Combiner 函数在 Map 节点本地预聚合,减少 Shuffle 阶段的数据传输量。
四、这篇论文的局限与边界?
即第三问设计选择所决定的代价和边界。
局限性
来自编程模型的限制
- 无法表达迭代计算。机器学习训练、图算法(PageRank)需要多轮迭代,每轮都要把中间结果写入 GFS 再读出来,产生大量不必要的磁盘 I/O。这是 MapReduce 被 Spark 取代的根本原因。
- 无法表达数据之间有依赖关系的计算。编程模型假设每条数据相互独立,一旦计算逻辑需要跨记录的状态共享,MapReduce 就无法自然表达。
来自执行拓扑的限制
- 全局 Shuffle 屏障导致资源利用率低。所有 Map 必须完成才能开始 Reduce,后完成的少数 Map 任务会让整个集群的 Reduce 节点空等。这被称为掉队者问题(Straggler Problem),论文通过推测执行缓解但无法根本解决。
- 多阶段计算必须串联多个独立作业。每个作业的输出写入 GFS,下一个作业再从 GFS 读取,产生大量不必要的磁盘 I/O 和网络传输。
来自中心化 Master 的限制
- Master 是单点故障——论文承认 Master 故障会直接终止整个作业,需要用户重新提交。对于运行数小时的大型作业,这个代价很高。
- Master 是性能瓶颈——所有任务状态追踪、故障检测、任务分配都集中在 Master,在极大规模集群下 Master 会成为瓶颈。
来自任务重试的限制
- 无状态设计使得重试简单,但代价是没有任何中间状态可以被复用。对于长时间运行的任务,这个代价很高,可能会导致已完成的工作白费。
边界
实时流处理场景
- MapReduce 假设数据是有界的完整数据集。一旦数据是持续到来的无界流(实时日志分析、实时推荐),批处理模并不适用。
低延迟场景
- MapReduce 的全局 Shuffle 屏障和批处理模型决定了它的延迟以分钟甚至小时计。任何需要秒级或毫秒级响应的场景,MapReduce 无法满足。
任务不可重试的场景
- MapReduce 假设任务失败可以直接重试,这要求任务是确定性的、无副作用的。一旦任务有外部副作用(如发送邮件、扣款),重试会导致副作用被执行多次,MapReduce 的容错机制失效。
数据之间存在复杂依赖的场景
- MapReduce 假设数据相互独立。图计算、强化学习等场景中节点之间存在复杂的数据依赖,无法被 Map+Reduce 两种操作自然表达。
需要细粒度资源控制的场景
- MapReduce 的编程模型把所有底层细节封装在框架内,程序员无法干预调度、内存管理、数据分区的具体行为。对于需要精细调优的高性能计算场景,这种高层抽象反而成了障碍。
五、这篇论文和其她工作的关系是什么?
-:同时代有没有解决类似问题的不同方案?
往前看
前人方案是什么,为什么不够?
前人处理大规模并行计算的主要方案是 MPI(Message Passing Interface)。MPI 给程序员完全的控制权——任意节点间通信、任意同步模式、任意数据传输。这在科学计算场景(气候模拟、基因组测序)下是合理的,因为那些计算任务本身就有复杂的数据依赖,无法被简单的高层抽象覆盖。
但 MPI 在 Google 的场景下有两个根本缺陷:
第一,容错完全由程序员负责。MPI 没有内置的容错机制,节点故障时程序员需要自己处理状态恢复和任务重启。在数千台廉价机器组成的集群上,故障是常态而非例外,把容错压在程序员身上是不现实的。
第二,学习和使用门槛极高。Google 的工程师大多不是分布式系统专家,让他们手动管理节点间通信和同步是巨大的工程负担。
这篇论文的出现是必然的吗?
在 Google 的特定场景下是必然的——TB 级批量数据处理的需求已经存在,GFS 提供了存储基础,缺的只是计算层的抽象。但 MapReduce 这个具体形式不是唯一可能,有人可以设计出不同的编程模型来解决同样的问题。MapReduce 的出现是必然的,但它的具体形态是 Google 对问题洞察的产物。
往后看
直接改进 MapReduce 局限性的工作
Spark(2010):针对 MapReduce 无法高效表达迭代计算的局限,把编程模型从 Map+Reduce 扩展到任意 DAG 变换,并把中间结果保留在内存而非写入磁盘。同样的核心洞察(固定操作模式 + 框架自动化),但覆盖了更广的计算场景。
Apache Tez(2013):针对 MapReduce 固定两阶段执行拓扑的局限,允许用户定义任意 DAG 的执行计划,消除了不必要的 Shuffle 屏障。
把 MapReduce 思想用在新场景的工作
Pregel(2010):把 MapReduce 的洞察迁移到图计算场景——把图算法归纳为以顶点为中心的消息传递模式(BSP),让框架自动处理图的分布式执行。
Hadoop(2006):MapReduce 的开源实现,把 Google 内部系统带给了整个工业界,直接催生了大数据生态系统。
Hive、Pig(2008-2009):在 MapReduce 之上构建更高层的查询语言(类 SQL),进一步降低了大数据处理的使用门槛。
流处理方向
Storm(2011)、Spark Streaming(2012)、Flink(2014):针对 MapReduce 无法处理实时数据流的边界,把批处理模型扩展到流处理场景。Flink 最终实现了流批一体——同一套编程模型同时支持有界批处理和无界流处理。
横向比较
Dryad(2007,Microsoft Research)
与 MapReduce 同时代,解决的是同样的问题——大规模数据并行处理。但 Dryad 选择了不同的方向:允许用户定义任意 DAG 的执行拓扑,而不是固定的 Map+Reduce 两阶段。
这说明当时存在两种不同的洞察:
- MapReduce:激进地限制编程模型,换取极度简单的自动化
- Dryad:保留更多的表达能力,代价是用户需要显式定义执行图
历史证明 MapReduce 的方向在工业界更成功——简单性和低门槛的价值超过了表达能力的限制。但 Dryad 的思想最终通过 Spark 和 Tez 回归了主流。
Hadoop vs. MapReduce 原版
Hadoop 是 MapReduce 的开源实现,但并非简单复制。Hadoop 在资源管理上做出了改进——YARN(2012)把资源管理从 MapReduce 框架中剥离出来,使得同一个集群可以同时运行 MapReduce、Spark 等不同的计算框架,解决了原始 MapReduce 资源利用率低的问题。